
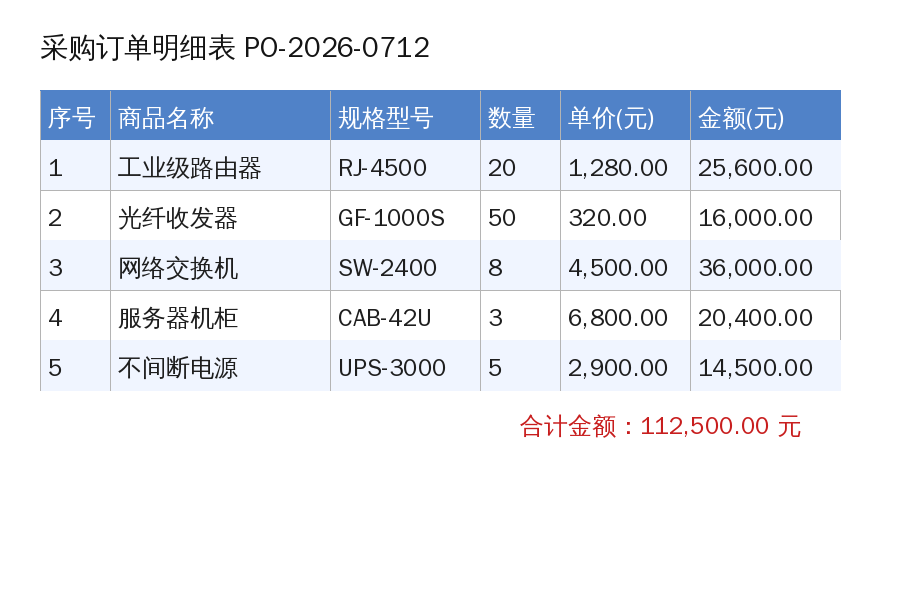
项目原有的 900×600 合成采购表,包含标题、六列表格、五条商品和合计;展示图与 9 月 3 日推理原件解码像素一致,未用新合成测试替换这份历史证据。
查看画廊与说明用途与结果
最快了解这个项目
为什么需要它
直接复制不了的文字需要识别,但只得到一大段文本常常丢掉金额所在列、脚注位置或多栏阅读顺序。这个工具把文字和原页面位置一起交回,并指出哪些页没处理完、哪些字还需要回看。
举个实际例子
“把这几张扫描表格里的文字提出来,保留每一行对应的金额;看不清的地方标出来。”先处理实际扫描页,返回文字和位置;若文件本来就有可提取文本,则先用原生文档读取,不多跑一遍OCR(光学字符识别)。
最后我会得到什么
拿到可复制的文字和可对照原图的位置说明;选择表格或公式时还会保留它们的关系。工具会说明处理了哪些页、哪些字不确定,关键数字仍要回原图核对。需要程序处理时也有结构化结果文件。
正常时
处理完成时返回实际输出文件、按页文字、识别方式和质量说明;需要结构时保留表格、公式或区域信息,便于继续使用并对照原图。
发现问题时
字小、低对比、布局复杂或首轮结果不足时,自动模式可以在本机增强;仍读不清、只完成部分或模型失败就说明具体问题,初步文字与正式完成结果分开。
入口不可用或证据不足时
原件打不开、环境不可用、端口不是本服务或显卡资源冲突时,返回明确原因和现有任务位置,不输出假结果,不擅自上传云端,也不反复创建同一任务。
从哪里开始
把图片、扫描 PDF 或文件夹拖到本机 LocalOCR 的 start.bat;在已接入 LocalOCR 的 AI 对话中也可指定原件和结果要求,由 ocr_smart.ps1 接住有界识别。
需要准备什么
- 本次明确的图片、扫描 PDF 或文件夹
- 只提文字,还是保留表格、公式、区域
- 目录是否递归及关键字段
从开始到拿到结果
- 1先判断是否真的需要识字
系统检查输入是否已经有可直接读取的文字;只有图片或扫描部分才交给本地文字识别。
- 2按内容选择识别
普通图片先提字,复杂页面或明确结构需求使用相应本地路线,显式选择优先。
- 3拿到内容和状态
交回文字、结构文件、页码位置及覆盖和质量说明;超时先查原任务。
- 4对照原件使用
关键姓名、数字、公式和表格关系回看原图;识别不清或模型不可用时保留缺口,不把空结果判成无字。
从这些需求了解功能
从一个实际问题看它怎样处理、交回什么;当前能做到哪一步和仍有哪些限制,也写在对应说明中。
同一张合成原图与一次真实运行
看得见表格恢复,也看得见标题遗漏与错字
第一张是项目合成采购表原图,第二张是 2026 年 9 月 3 日真实输出的可读排版。表格和合计未经手工补写,标题遗漏、PO 读成 P0 与质量未知保留;这不是新版本复跑或准确率宣传图。打开后可缩放、滚动查看细节,也可关闭或切换上一张、下一张。
项目指标与相关入口查看规模、覆盖范围和关联能力
当前项目指标
- 识别路线
- 3 条
- 正式输出
- TXT · MD · JSON
- 9 月 17 日普通回归
- 174 通过 · 1 跳过
- 9 月 17 日合成验收
- 9 案例 · 3 路线
它负责
- 接收本次指定图片、PDF 或文件夹,规范路径并明确递归范围,保留输入与输出的对应关系。
- 提供日常提字、困难文档增强和显式结构解析三条本地路线,保留实际模型与选择原因。
- 交回可读、可复制、可编程处理且可对照原图的文字与结构,不抹掉模型原始分歧。
- 把执行、覆盖、质量、空结果和失败分开描述,并用一条人话摘要帮助先看懂状态。
- 在相同请求下复验并复用结果,提供指定任务查询、取消、超时和资源冲突处理。
- 维护当前依赖、模型配置与本机启动方式,使环境损坏或换机时有明确重建入口。
它不负责
- 不负责整库查找、照片归类、文书事实判断或后续成品排版;原件查找回到“个人材料查找”,照片视频回到“个人媒体整理与恢复”,文书产出交给“文书和材料制作”与相应文档工具。
- 不自动生成可编辑 Word、Excel 或可搜索 PDF;不会把识别出的文字当成原件真实性、印章真伪或公式正确性的证明。
- 不公开接收文件、不提供公网识别 API、不自动上传私人输入,也不引入身份识别或无人值守全库扫描。
- 不因平均分高、缓存命中或测试通过,就承诺任何输入逐字准确;重要字段保留人工复核入口。
产品思想与设计核心
先按任务选工具,不让每张图都跑重模型
只想知道照片里有什么时,直接看图通常足够;需要逐字文字、批量处理、表格、坐标或全本地执行时才用 LocalOCR。已经有文字层的数字文档先走原生读取,避免把清楚的文字重新变成有误差的图片识别。
普通页面先轻量读,困难页再加强
按页面实际内容决定是否提高识别强度,只处理看不清的问题页;本人明确指定模型时保留该选择。要表格结构须另说清,不会被自动路线暗中替换。
保留原始识别,不把顺口的改写当成读到了
原始文字、页码、坐标和分数是复核依据。AI 看原图后若发现某个浅色小字有误,应把更正与具体区域单独说明,不能覆盖原始 OCR(光学字符识别) 或声称引擎自动读对;无法判断就保留未知。
一份结果要同时说清做完没、读全没、可信到哪
任务完成、页面覆盖、结果质量和有没有检测到文字是不同问题。空文本可能是图片无字,也可能是模型没读出来;只有相应独立证据成立才给出没有文字的窄结论。
重复请求先看旧结果,等待超时先找原任务
同一文件和要求只有在旧结果完整且对应当前版本时才复用。窗口等待超时不表示后台已停;先查原任务再决定等、取消或重新处理。
识别任务不能把电脑一直占住
需要显卡时使用现有资源协调;超时、取消或资源冲突只处理本次识别,不为了排队额外建立一套长期后台任务。
升级先验独立版本
新版先在旁边试真实样例,再决定是否切换;旧版须仍能实际打开和识别,只有目录或一次健康响应不能证明可回退。
它读哪些文件,交回什么
只读取这次明确选中的图片、扫描 PDF 或文件夹;每个结果都能回到对应原件和页面,不会后台扫描私人目录。
PNG、JPG/JPEG、WebP、BMP、TIF/TIFF 中的文字像素,包括界面文字、纸张照片和中英文混排内容。
文字块、位置、顺序和识别分数;纯粹描述景物或颜色时可以直接看图,不必启动文字识别。
先核对实际页数,再逐页把扫描部分转成可识别的图;已有可读文字的 PDF 优先直接读取。
按页交回文字和版面位置,关键数字仍要对照同一原页。
只处理支持的图片和 PDF,按请求决定是否递归子目录;每个文件分别选择识别路线,共享整次请求的期限。
逐文件输出与对应身份,不把一个目录变成长期资料库或持续同步任务。
只有明确要求保留行列、公式或区域时才选结构解析。
交回可读表格和结构化文件;识别到印章不等于证明真伪,公式文字也不等于推导正确。
“全部处理留在本机”是可明确提出的要求。若同时需要场景理解和逐字抄写,AI 可以在获准的处理范围内分别看原图与读取 OCR(光学字符识别) 证据,再分开说明观察、文字、状态和冲突;LocalOCR 本身不调用外部视觉模型。
项目怎样演化到现在
从能识别,到能看见任务怎样执行
从拖入一张图取得文字,发展到能查看任务进度、服务是否忙,以及复杂页面需要怎样加强;出错不只剩一个空窗口。
阶段依据
- 2026-07-12—2026-07-29 · 从能识别,到能看见任务怎样执行
c8fa63a—ad5cad4
从有文字,到知道是否读全读对
开始分开说明处理完没有、页是否齐全和文字是否可信;表格、页码和位置也一起保留,不拿整齐排版代替内容正确。
阶段依据
- 2026-08-17—2026-08-27 · 从有文字,到知道是否读全读对
8191be3—9c49193
从一次输出,到逐页复核和可回滚升级
重复识别先核对可复用结果,升级环境先试独立候选并保留旧版;重要字段仍可逐页回看,完整离线新机恢复另需材料。
阶段依据
- 2026-09-01—2026-09-17 · 从一次输出,到逐页复核和可回滚升级
acc6d15—3a4bf13
完整项目状态与证据边界
已确认事实
- ocr(光学字符识别) → ppocrv6-medium:PP-OCRv6_medium;保留方向与文本行处理,平面截图默认关闭形变矫正。
- vl → paddleocr-vl-1.6:PaddleOCR-VL-1.6;可显式选择。auto 先普通 OCR(光学字符识别),再根据逐页空结果、低置信度或表格/公式内容信号只增强问题页,保留首轮文字与坐标,不按文件名猜版式。
- structure(结构化版面) → pp-structure-v3:PP-StructureV3 + PP-OCRv5;表格、公式、印章和区域处理需显式选择,图表识别当前关闭。
- PUBLIC(公开)仓库 wlyaaaaa/LocalOCR,正式回读 main=origin/main=3a4bf13eb95beac540ce11b323e48ba53c1459db,工作树干净。开发源码与正式运行的冻结 app 快照分离,未发布修改不会自动进入现役服务。
- 项目 0.7.0,Python >=3.10;声明 paddlepaddle-gpu>=3.3.1,<3.5、paddleocr==3.7.0、paddlex==3.7.2,正式锁文件为 requirements/runtime-paddle-cu129.lock.txt。当前实装为 WSL(Windows 的 Linux 子系统) Python 3.12、Paddle GPU 3.4.0/cu129、PaddleOCR 3.7.0,不把依赖允许区间当实际安装值。
- Windows有界入口为ocr_smart.ps1,直接API入口为ocr_once.ps1;拖入start.bat或调用start.ps1通过PowerShell 7.3+的pwsh进入localocr.cli。中文/空格路径转换为WSL(Windows 的 Linux 子系统)路径,批处理固定Windows CRLF行尾。CLI(命令行)与API继续共用OCRService、自动增强、执行监管和输出合同。
- 固定本机 127.0.0.1:18665;一个可替换的 warm worker(温热推理进程);同模型复用、换模型回收。默认整次请求期限 300 秒,最大 7200 秒,服务进程树内存上限 30,000,000,000 字节。
- localocr/model_profiles.json 声明 3 个具体 profile(模型配置档),由 model_registry.py 解析;显式模型选择不被自动分流改写。普通 OCR(光学字符识别) 配置的能力标签含形变矫正,但 use_doc_unwarping=false,不能把支持标签当成已开启。
- 任务与缓存同时绑定原件内容、请求语义、逐页路由、具体模型配置、实际权重、实现和运行库。正式 TXT/MD/JSON 与 media.objective-result.v1 客观文件按请求隔离并复验;逐页原子检查点可作为超时/中断后的部分证据,不自动升级为完整结果或自动续跑。
- PDF/TIFF 的实际页数/帧数先独立计数。当前逐页 PDF 渲染按 profile 的 216 DPI、24,000,000 像素上限选实际比例,JSON 保留页码、真实渲染尺寸、比例与坐标空间;旧兼容函数默认 scale=2.0。文字与识别后几何严格配对,非线性矫正空间不能冒充原图点坐标。
- 生产者可根据独立证据形成 no_text_detected,但未保存时仍不是可采纳的持久验真结果;调用方只有在完成、完整、充分及证据保存/字节/身份复验均成立后,才把它作为已验证的无字结论。内置证据主要限于近乎均匀图片。
- 本轮 inspect 回读 /root/localocr-runtimes/current → /root/localocr-runtimes/paddle-3.4.0-20260917;实际源码位于该版本 app,Python 3.12、localocr 0.7.0、Paddle 3.4.0、PaddleOCR 3.7.0、PaddleX 3.7.2、pypdfium2 5.11.0、FastAPI 0.139.0、uvicorn 0.50.0、httpx 0.28.1、psutil 7.2.2。只读取元数据,未导入模型。
- 冻结源码 SHA-256=471a4216e880a95ab6bb4fbbb39d34b8a5a3bdb49caaa3fd21eee40554fb18e9;profile 文件=c8bb75868078f66ffa46cd5e75e8c4799f2708475e5f8527d71e08b118797073。实际模型指纹:OCR(光学字符识别)=db0365ca76890841dc1239b77a8e51e8b7feea1e72f6a9a591496b344f2125b7;VL=e57bafebef2dd975e7a588f3ba6fc6377c05cca999ae4cd1ee619d415bea5f7e;Structure(结构化版面)=6be66ded72be6667f7f949ed8d3f01987c75169dc19254d6409e2f96b10ea74b。
- 9 月 17 日 07:39 UTC 候选验收:依赖、175 项普通测试(174 通过、1 跳过,41.814 秒)和 9 个禁用结果缓存的合成质量案例通过,输入/运行身份稳定,总计 325.768 秒。本轮读取 acceptance/acceptance.json、quality.json 与 unit.log,没有重新运行。9 月 3 日首次 RSS 恢复 ConnectionResetError 仍是历史异常,不声称已证明根因。
- 保留 9 月 3 日采购表及原始输出供复核:structure(结构化版面) / pp-structure-v3 读出 1 页、六列五条商品与合计 112,500.00 元,约 27 秒。9 月 17 日新增 9 个合成案例覆盖普通/旋转/小字/空白、两帧 TIFF、VL 图/PDF、结构表格与自动表格路由;不是同一旧采购表复跑,也不是现实文档准确率排行榜。
- 旧采购表虽然 completed/complete,Markdown 仍漏 figure_title,原始 text_lines 把 PO 读成 P0,quality=unknown(未验证)。9 月 17 日两页 VL 样例 CER=0.01333,关键字段齐全但把“请保留”读成“清保留”;其余通过阈值不能抹掉这处字符错误。
- 原图 67,474 B,SHA-256=a4715280b4818eaad9d11361e77eb1698cb7c47dc06da66d97fbcae580938410;实际 Markdown 1,030 B,SHA-256=08bee52074af89a00b503d2f89e77ec8bc75fb3ff7e190e95c64c0f4341e86d3;正式 JSON 71,158 B,SHA-256=9166e6012c0e30e9e392367e4dfb08ee6a8c9290d8e07cfd3e4cedcb1d695527。
- 9 月 17 日 Windows E2E(端到端验证) 回执绑定 3a4bf13:真实切换到 Paddle 3.4.0,回滚到保留的 3.3.1 冻结环境,再恢复新版本;首次普通 OCR(光学字符识别) 27.951 秒,复用同一已验输出 1.284 秒,均为 1/1 页。停止入口一度因错误 WslTimeoutSec=20 参数未执行,改用允许的 10 后释放、重启回读成功,最终 stopped_on_demand。本轮 9 月 18 日 13:20 UTC /health 拒绝连接,符合按需停止状态,不冒称在线或故障已根治。
当前缺口
- 真实采购表样例已揭示具体输出缺口:figure_title 被过滤出正文,标题中的 O 被读为 0;JSON 的 text_lines 与 excluded_regions 保留了复核线索,不能把它缩成泛泛的“模型可能出错”。
- 当前按需停止,下一次任务仍要现场启动并核对身份。来源已完成真实重启与释放验收,但本轮没有启动服务或推理;旧样例完成后不可达的历史不再代表缺少现行恢复证据。
- 普通回归第一次出现一次 RSS 越界后的恢复 ConnectionResetError,聚焦与完整复验均通过;波动原因本轮未定,不宣称已根治或长期稳定。
- auto 不再按文件名分流;它依据实际逐页 OCR(光学字符识别) 质量和结构信号增强,仍不是保证理解所有版式。structure(结构化版面) 继续必须显式选择,复杂表格和公式准确性仍需原图验证。
- 模型置信度和整页质量不是逐字正确率。小字、浅色字、姓名、日期、金额、公式与表格对应关系仍需回到原图复核;结果文件的哈希只证明对应关系与字节一致。
- 当前导出是 TXT、Markdown 和 JSON,不是直接生成可编辑 Word、Excel 或可搜索 PDF;后续编辑和排版由对应文档工具完成。
- 版本化安装、激活和实机回滚已经验收;完整断网新机还需要事先保留 WSL(Windows 的 Linux 子系统)、系统依赖、Python 包和权重,现有联网候选安装器不是一份全离线恢复包。
- 本轮不进行私人材料批量扫描、跨模型重型基准或真实离线重装;这些结果不能由源码、单元测试或一个合成样例替代。
来源与公开边界
LocalOCR 是独立的公开本机工具,源码位于 wlyaaaaa/LocalOCR。模型推理由本机 Windows 与 WSL(Windows 的 Linux 子系统) 中的环境完成,网站只展示产品、实际使用方式和最后一次核对的证据,不接收访客文件,也不是在线 OCR(光学字符识别) 服务。公开样例使用项目的合成材料,不代表私人文件或任意文档的识别效果。
当前关键技术事实
- 日常提字
- ocr(光学字符识别) → ppocrv6-medium:PP-OCRv6_medium;保留方向与文本行处理,平面截图默认关闭形变矫正。
- 困难文档
- vl → paddleocr-vl-1.6:PaddleOCR-VL-1.6;可显式选择。auto 先普通 OCR(光学字符识别),再根据逐页空结果、低置信度或表格/公式内容信号只增强问题页,保留首轮文字与坐标,不按文件名猜版式。
- 结构化解析
- structure(结构化版面) → pp-structure-v3:PP-StructureV3 + PP-OCRv5;表格、公式、印章和区域处理需显式选择,图表识别当前关闭。
完整执行流程
- 1先把原件和目标说具体
指定本次文件或文件夹,说清只要文字,还是需要表格、公式、印章区域和坐标;需要严格本地处理时一并说明,目录递归单独选择。
- 2确认入口可用,而不是只看进程还在
正常调用入口读取本服务健康与活跃任务;无服务时使用现有启动入口,忙碌或身份不符时返回具体状态,不抢占别的程序端口。
- 3固定本次输入,再决定识别方式
规范路径并独立核对页/帧数,绑定输入、实际模型与运行身份;auto 先 OCR(光学字符识别),再据逐页质量和结构信号判断,显式模型始终优先。
- 4先查能否复用,确有需要再推理
已有相同请求的正式结果时复验文件、大小、哈希与客观结果文件;不满足条件才执行。一个目录的所有文件共享本次期限,不按文件无限延长。
- 5按页提字、必要时本地增强
按页有界渲染与识别,auto 仅将问题页转本地 VL,并保留首轮文字/坐标;超时或中断可留下原子部分证据。显式结构需求单独执行,增强失败不能把初步输出提升为完整成功。
- 6同时交回内容和读懂它的说明
保存 TXT、Markdown、JSON 与客观状态文件,返回精确结果路径;人话摘要说明文字块、覆盖、质量、分数、增强和警告,不能替代原始文字。
- 7对照原图后再用于下一件事
核对姓名、数字、日期、公式与表格关系;需要后续写文书或做表格时把经复核结果交给对应工具,而不是让识别引擎顺带替人作事实判断。
本页用到的名词
需要核对专业含义时,可以在这里查看它在 LocalOCR 项目中的具体用法。
- OCR(文字识别)
- 从图片像素中识别文字;与直接读取数字文档的文字层不同,会受字大小、对比度和版面影响。
- VL(视觉语言识别)
- 这里指本地 PaddleOCR-VL 文档路线,不是任意云端视觉聊天服务。
- profile(模型配置档)
- 绑定引擎、适配器、模型版本和选项的具体配置;一个引擎族与一个具体配置不是同一个概念。
- bbox / rect / polygon(兼容区域 / 矩形 / 多边形)
- bbox 是兼容区域字段,在普通 OCR 中可能仍是多边形;统一矩形使用 rect,多边形使用 polygon。PDF 结果属于渲染像素,矫正后还应核对实际图像空间。
- objective sidecar(客观结果伴随文件)
- 独立保存执行、覆盖、质量、证据绑定和文字检测结论的 JSON;它不替代正文,也不是外部鉴定。
- job key(任务标识)
- 由源文件内容、请求和模型等身份生成的结果定位;不能仅靠文件名判断任务相同。
- cache hit(结果复用命中)
- 已保存结果通过当前完整性和身份检查,可以省去重复推理;不意味着文字百分之百正确。
- warm worker(温热推理进程)
- 同一模型可留在进程中供后续请求复用;模型切换、取消或执行故障会触发对应回收。
- LocalGpuBroker(本地显卡协调器)
- 现有机器能力负责协调 LocalOCR 与其他重模型的显卡使用,不由这个网页创建。
系统里实际有什么
下面是当前产品组件,不是概念分类。每一项都对应真实文件、入口或验证链。
接住拖入文件、自然语言调用和有界等待,区分不存在、忙碌和错误服务。
start.bat、start.ps1、ocr_smart.ps1、ocr_once.ps1、start_server.ps1;固定本机 18665,18666 不是后备端口。
分开文件枚举、自动路线、显式模型和困难结果增强。
router.py、smart_router.py、difficulty.py、model_registry.py、model_profiles.json;由 service.py 执行实际增强。
分别完成普通文字、复杂文档和完整结构解析,并统一输出字段。
engines/ppocrv6.py、engines/vl.py、engines/structure.py;保留原始结果并补齐文档块和坐标,不把模型选择写死在入口。
把指定 PDF 的页面变成可识别图片,明确页尺寸、渲染比例与坐标所属空间。
pdf_utils.py 与适配器独立核对真实页/帧数;iter_input_pages 默认 216 DPI、24M 像素上限,每次只保留一张临时渲染页。JSON 记录实际比例和尺寸,不混用原 PDF 点、渲染像素与非线性矫正空间。
同时交付可读文件、程序结构及有证据约束的识别结论。
outputs.py、objective_result.py;display_summary 只投影现有字段,正式结果按请求隔离。
让 CLI(命令行工具)/API 共享同一执行方式,检查缓存、活跃任务、原件变化与正式结果提交。
service.py、job_registry.py、checkpoints.py、server.py;实际模型工件、冻结实现与运行库参与身份,失败的逐页证据与成功缓存分离,取消终态不可自动重试。
在同模型复用的同时保留期限、取消、内存和进程回收。
runtime.py、gpu_broker.py、gpu_probe.py;管理本服务进程树,不把上限施加到整台电脑。
让调用方知道阶段、进度与结果状态,并能按当前环境配置重建。
observer.py 只投影运行状态;install_wsl.sh 创建锁定依赖和冻结 app 的候选,manage_runtime.py 提供 inspect/validate/activate/rollback。current(当前状态)/previous 分开,模型预下载需明确选择,不在安装末尾自动加载。
照片原件与显示版本
缩略图用于快速浏览,点开后才加载大图。经过转换或压缩的显示副本与来源原件分别标明,下面可下载网页使用的大图。
显示尺寸 900 × 600 · 24,266 B · SHA-256 f447631806fbe26406a963d2cf87942ad03e7893db6ced3bd0608c60a34d0c22
来源原件 900 × 600 · 67,474 B · SHA-256 a4715280b4818eaad9d11361e77eb1698cb7c47dc06da66d97fbcae580938410
WebP(网页图像格式)无损显示副本;保持 900×600 尺寸,解码后的 RGBA(红绿蓝及透明度)像素与来源 PNG 逐字节相同。来源身份仍保留原 PNG 的 SHA-256 和字节数。
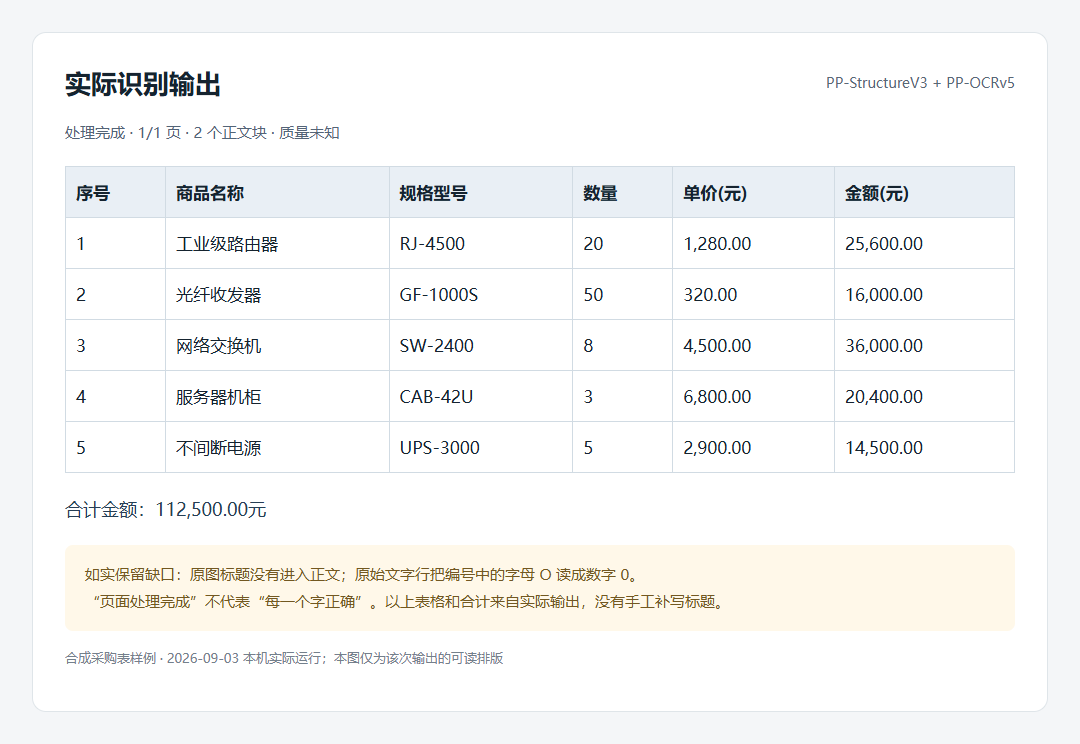
显示尺寸 1080 × 744 · 20,348 B · SHA-256 966777c0a89a56a54a93c766418ca9060470daf7cef11be3d052497828cddd9a
来源原件 1080 × 744 · 54,785 B · SHA-256 999d71b8bf29cbb11f4fad06a3fc45cd4c7336ffa0be0060615c61afa65a3ff1
WebP(网页图像格式)无损显示副本;保持 1080×744 尺寸,解码后的 RGBA(红绿蓝及透明度)像素与来源 PNG 逐字节相同。来源身份仍保留原 PNG 的 SHA-256 和字节数。
5 层证据分别证明什么
能证明:当前公开主分支实际包含的输入、三条模型路线、输出、任务和资源处理逻辑。
不能证明:某台机器已装齐依赖、每个模型正在运行或任意图片识别准确。
能证明:9 月 17 日普通回归 174 通过、1 跳过,覆盖分流、几何、结果与任务合同;本轮只读回执,没有重新执行。
不能证明:真实显卡加载、模型准确率、长文档耗时和新机恢复效果。
能证明:本轮 inspect 确认已选择的冻结代码、Paddle 3.4.0、依赖与模型指纹和接受回执相符;服务按需停止,在线状态不由安装存在推定。
不能证明:所有登记模型均已加载,也不证明当前文件完成识别。
能证明:9 月 17 日九个合成案例及 Windows 首次/缓存请求有真实结果,切换与回滚有独立身份回读;旧采购表原图和输出仍以原日期保留。
不能证明:私人文档、不同布局和每一个关键字都正确;一个样例不是全模型基准。
能证明:结果对应本次输入、请求与模型,保存字节可核对;对照检查能确认被检查的具体区域。
不能证明:未检查部分正确、原件事实真实、印章真实或外部机构认可。
维护入口
E:\Projects\Tools\LocalOCR\ocr_smart.ps1 '<明确文件或目录>' -Engine auto日常本机入口:正常先看服务与任务状态,再提交有界识别;需要结构时显式 -Engine structure(结构化版面),需要具体模型时指定 -Model。
pwsh -NoProfile -File E:\Projects\Tools\LocalOCR\start.ps1 '<明确文件或目录>' --engine auto --timeout-sec 300一次性命令行:拖拽/单次入口要求PowerShell 7.3+;与API共用OCRService和正式输出,退出时关闭自己的执行服务。
GET http://127.0.0.1:18665/health只看服务状态:核对本服务身份、active_jobs、驻留模型与显卡探测状态;active_jobs 缺失视为未知。
GET /jobs/<job_key> ; POST /jobs/<job_key>/cancel查询或取消指定任务:两条均使用本机 18665;先按返回标识定位,取消只针对明确任务,不能当成停止其他服务的入口。
scripts/run_in_wsl.sh -m unittest discover -s tests -q普通回归:验证非重型逻辑;需要跨模型真实集成时才单独评估 tests/run_tests.py --allow-heavy,不能把它当健康检查。
wsl -d Ubuntu -e bash /mnt/e/Projects/Tools/LocalOCR/scripts/install_wsl.sh <unique-candidate-name>重建环境:创建锁定依赖与固定源码的独立候选,不覆盖 current(当前状态)、不自动激活或预热。模型预下载与 validate --allow-heavy 需明确重型范围,通过后停止现有服务再切换;rollback 使用旧环境自己的已验证回执。
E:\Projects\Tools\LocalOCR\release_resources.ps1按需释放显卡资源:只有别的显卡任务确实需要资源时才释放;日常连续识别保留温热模型,避免反复冷启动。
快照怎样更新
本页代表最后一次明确核对并发布的项目状态,不承诺后台实时同步。再次更新时会重新读取该项目当前事实、边界和验证结果;无法确认的内容继续明确标成网页快照边界,不用旧记录猜成当前状态。